资源与训推割裂
算力、数据、训练、部署、评估分散,模型上线周期长。
企业 AI 应用进入生产阶段后,核心挑战从“资源能否交付”进一步扩展到“模型能否稳定上线、统一调用、持续运营和安全治理”。
不是模型能不能调用,而是能否稳定、低成本、可追责地持续运营。
算力、数据、训练、部署、评估分散,模型上线周期长。
本地模型、公有云 API、自研模型并存,业务接入标准不统一。
采购成本、用户消费、预算水位分散,难以做经营判断。
API Key 滥用、非工作时间调用、公司 Token 被用于非授权任务。
资源池化、调度、监控。
从开发验证到上线运营。
压测、观测、调优、验证。
账号、目录、成本、端点。
统一编码、配额、上下架。
面向生产运营和领导汇报。
平台管理对象从算力资源延伸至模型服务与调用全链路,让企业同时管好资源、模型、服务质量、成本和使用风险。
资源可用,是 AI 落地的起点
模型可管,才是企业 AI 生产化
底层算力能力仍然保留并增强,在此基础上扩展训推、高效推理和模型调度治理。
统一纳管 CPU/GPU/NPU/DCU、存储、网络和资源池,提供调度、监控、告警和运维保障。
支撑数据管理、训练任务、模型部署、评估验证和推理服务,缩短模型从研发到生产周期。
面向自部署模型提供压测、观测、调优和复盘沉淀能力,帮助模型服务从能用走向高效。
统一企业模型、服务端点、路由策略、配额限流、调用分析、成本预算和安全审计。
面向 Agent 场景开放模型服务、工具接入、任务执行和观测计量能力,让企业 AI Infra 成为可被智能体调用的基础设施。
紫东太初云可将平台能力封装为 Skill、CLI、SDK 等工具能力,支持用户通过 Agent 对话式发起模型调用、资源查询、任务提交和日志分析。
将平台能力封装为 Agent 可理解的技能能力,支持模型调用、资源查询、任务提交、日志分析等场景。
面向开发者和自动化流程提供命令行与 SDK 接入方式,支持把平台能力嵌入研发、运维和业务系统。
从用户路径、核心模块、系统关系到数据闭环,展示紫东太初云 AI Infra 的整体能力结构。
紫东太初云围绕企业 AI 应用落地,形成从算力资源供给、模型训推工程化、模型服务统一发布,到调用治理、成本运营和合规审计的完整业务闭环。
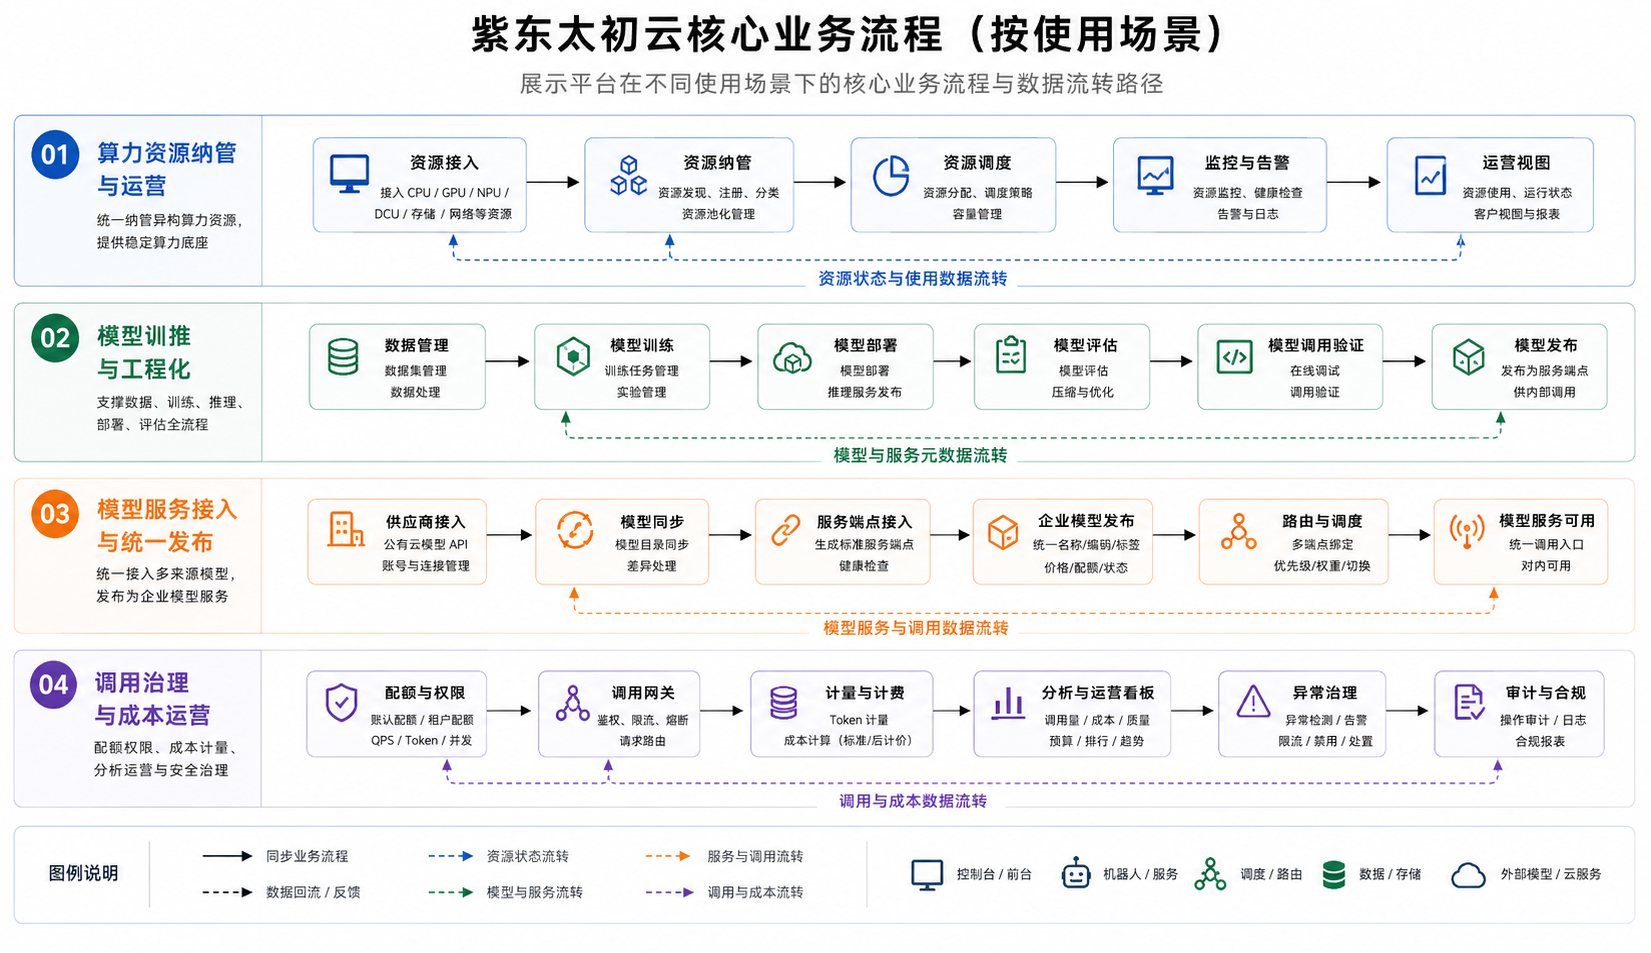
平台覆盖资源接入、资源纳管、模型训练、模型部署、模型发布、调用验证和运营分析,支撑企业 AI 能力从建设到生产运行。
资源状态、模型服务、调用行为、成本预算和审计日志持续沉淀,帮助企业形成可监控、可分析、可治理的数据闭环。
通过统一入口、标准流程和运营视图,企业可以同时管理多类算力、多来源模型、多租户调用和多维度成本。
围绕费用透明、服务稳定与安全可控,建立从模型调度到企业治理的完整运营能力。
不只是“成本治理”,而是把模型费用变成可解释、可汇报、可运营的管理视图。
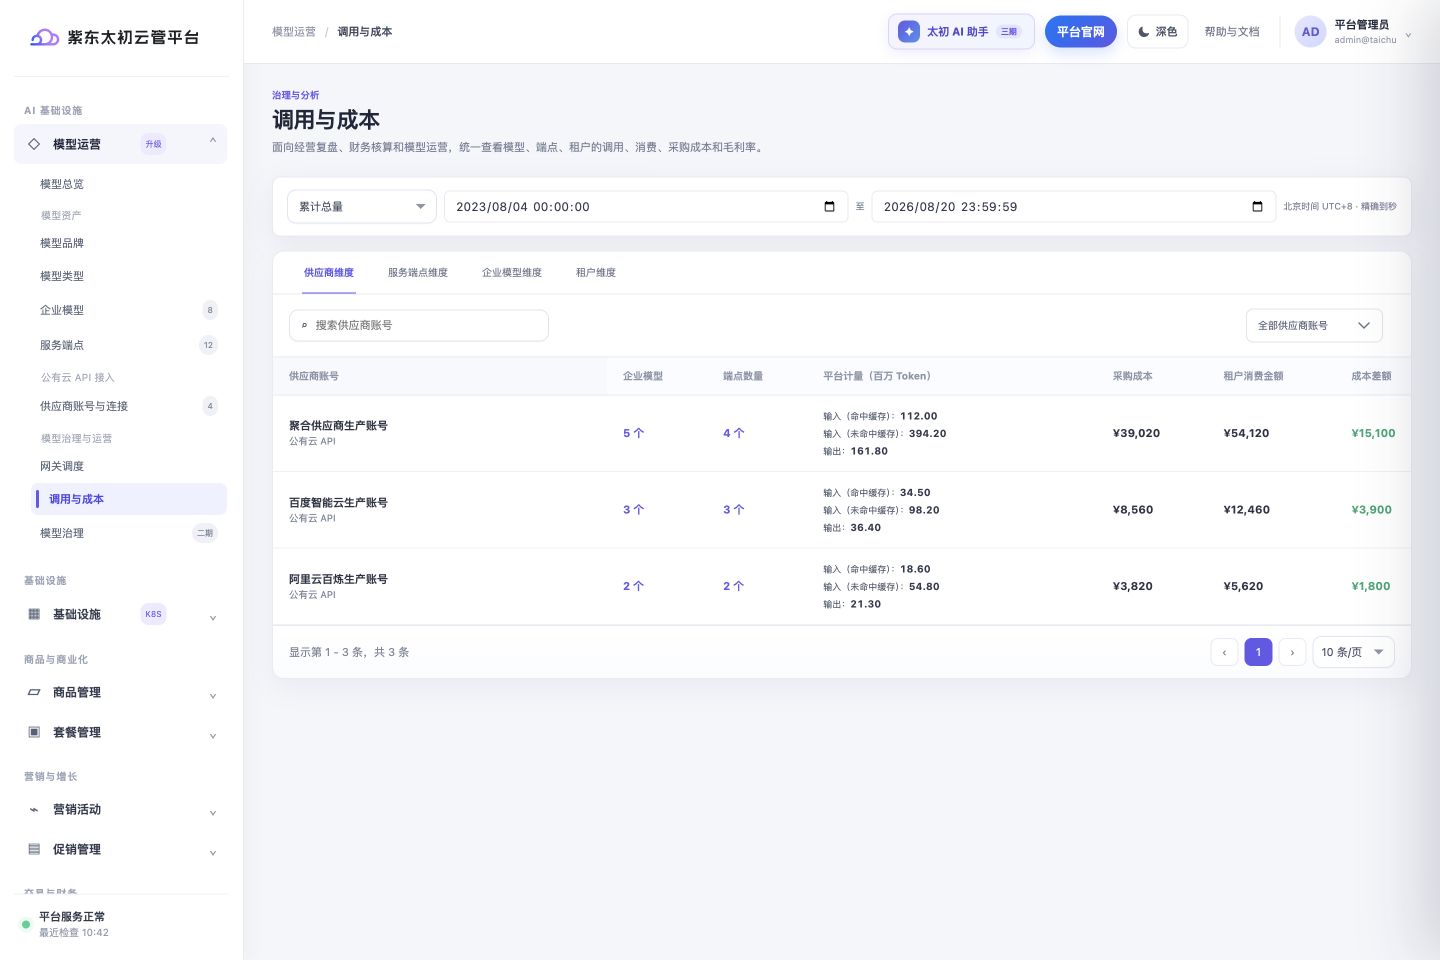
紫东太初云帮助企业完成从算力可用、模型可训,到推理高效、调用可控、成本可见、运营可持续的升级。
提升异构算力资源利用率,降低运维复杂度。
建立从数据、训练、部署到发布的标准模型工程流程。
通过压测、观测和调优,让自部署模型更高效。
多端点调度与故障切换支撑生产级连续性。
采购成本、用户消费和预算水位统一呈现。
识别 API Key 滥用、异常人员行为和上下文风险。